测试本地部署ChatGLM-6B | ChatGPT
测试本地部署ChatGLM-6B | ChatGPT
ChatGLM-6B介绍
ChatGLM-6B是一款中英双语的开源对话语言模型,使用General Language Model (GLM)架构,具有超过62亿的参数。通过模型量化技术,用户可以在消费级的显卡上进行本地部署,最低显存需求为6GB(INT4量化级别)。该模型类似于ChatGPT,专注于中文问答和对话,经过将近1T的中英双语标记符训练,并结合监督微调、反馈自助和人类反馈强化学习等技术,ChatGLM-6B已经能够生成非常符合人类偏好的回答。不同于其他模型,ChatGLM-6B旨在提供自然流畅、多样化的对话体验,实现人机交互的真正智能化。
部署
-
环境要求:
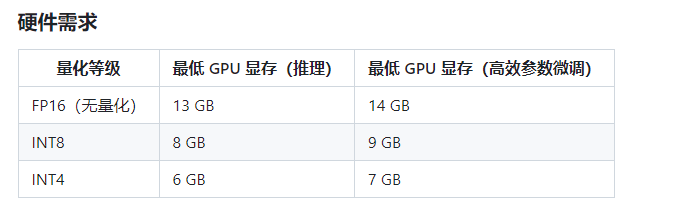
ChatGLM-6B 也支持CPU的推理,本文部署在linux GPU环境部署。
-
环境安装
conda create -n py38 python=3.8 source activate py38 git clone https://github.com/THUDM/ChatGLM-6B.git pip install -r requirements.txt -i https://pypi.tuna.tsinghua.edu.cn/simple ├── api.py ├── cli_demo.py ├── cli_demo_vision.py ├── examples ├── FAQ.md ├── improve ├── LICENSE ├── limitations ├── MODEL_LICENSE ├── PROJECT.md ├── ptuning ├── README_en.md ├── README.md ├── requirements.txt ├── resources ├── UPDATE.md ├── utils.py ├── web_demo2.py ├── web_demo_old.py ├── web_demo.py └── web_demo_vision.py -
模型和配置下载: ChatGLM-6B的模型的配置已经托管在huggingface上(https://huggingface.co/THUDM/chatglm-6b/tree/main),也可从清华云中下载模型文件(https://cloud.tsinghua.edu.cn/d/fb9f16d6dc8f482596c2/)
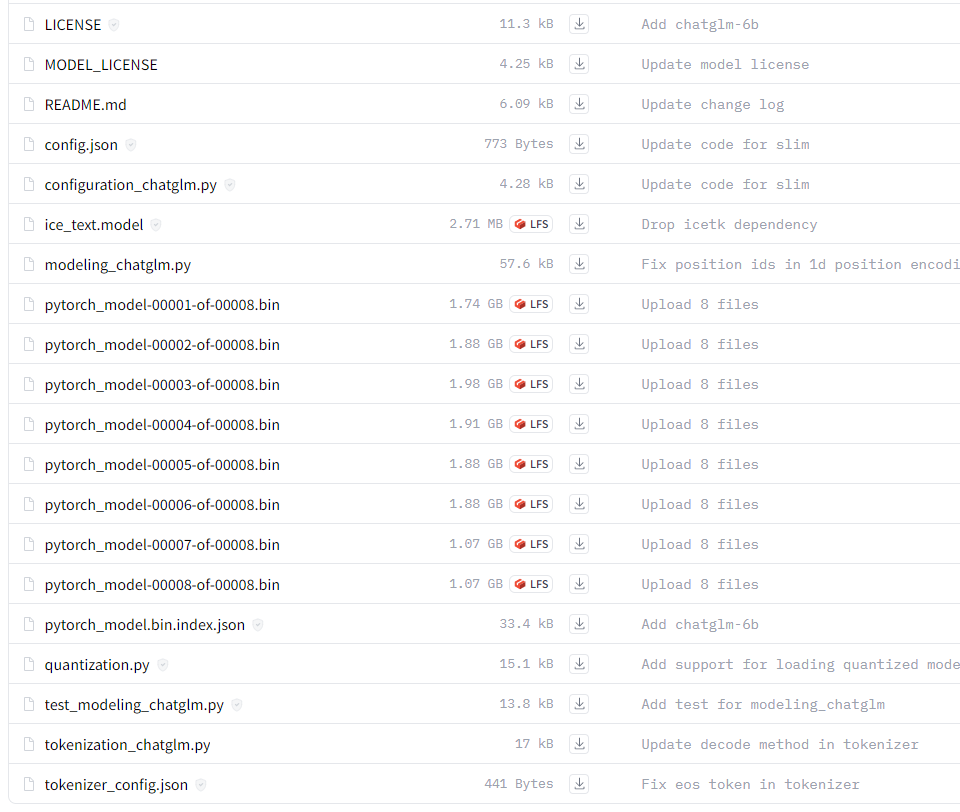
本次部署将模型和配置放在ckpt文件夹中
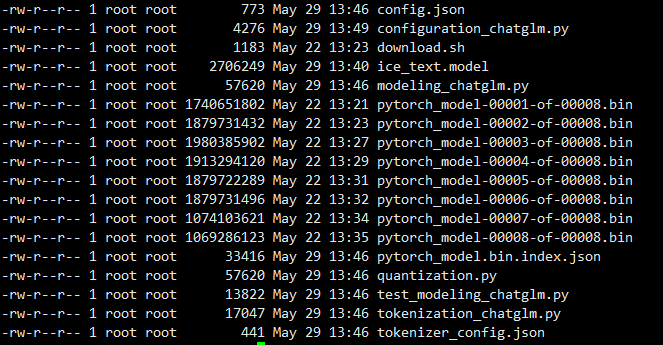
-
测试
测试主要是加载tokenizer和模型,将目录改为本地的目录如
ckpt,耐心等待加载完模型就可以测试了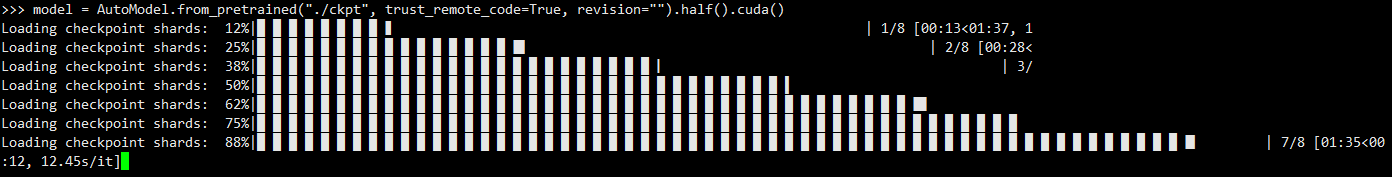
  from transformers import AutoTokenizer, AutoModel
  tokenizer = AutoTokenizer.from_pretrained("./ckpt", trust_remote_code=True, revision="")
  model = AutoModel.from_pretrained("./ckpt", trust_remote_code=True, revision="").half().cuda()
  model = model.eval()
  response, history = model.chat(tokenizer, "你好", history=[])
  print(response)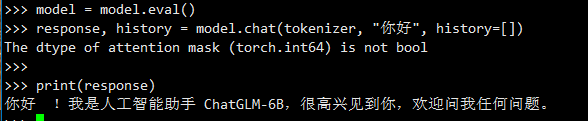

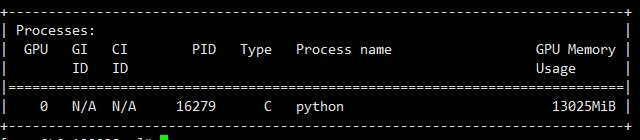
本文为半精度部署,显存占用为13G
ChatGLM-6B的应用
- ChatGLM-MNN: 一个基于 MNN 的 ChatGLM-6B C++ 推理实现,支持根据显存大小自动分配计算任务给 GPU 和 CPU
- JittorLLMs:最低3G显存或者没有显卡都可运行 ChatGLM-6B FP16, 支持Linux、windows、Mac部署
- InferLLM:轻量级 C++ 推理,可以实现本地 x86,Arm 处理器上实时聊天,手机上也同样可以实时运行,运行内存只需要 4G 基于或使用了 ChatGLM-6B 的开源项目:
- langchain-ChatGLM:基于 langchain 的 ChatGLM 应用,实现基于可扩展知识库的问答
- 闻达:大型语言模型调用平台,基于 ChatGLM-6B 实现了类 ChatPDF 功能
- chatgpt_academic: 支持ChatGLM-6B的学术写作与编程工具箱,具有模块化和多线程调用LLM的特点,可并行调用多种LLM。
- glm-bot:将ChatGLM接入Koishi可在各大聊天平台上调用ChatGLM