Claude Fable 5 深入解析:当 AI 学会“三思而后行”
Claude Fable 5 深入解析:当 AI 学会“三思而后行”
1. 神话与寓言:Claude 5 的双生之谜
2026 年 6 月 10 日,Anthropic 在一次颇为突然的发布中,带来了其最新的旗舰模型——Claude 5 系列。不同于以往逐步放出 Haiku、Sonnet、Opus 的节奏,这一次 Anthropic 一次性丢出了两颗“重磅炸弹”:Claude Fable 5 和 Claude Mythos 5 。
如果你是一位文学爱好者,可能会对这个命名会心一笑。“Mythos”意为“神话”,代表着原始、狂野且不受约束的力量;而“Fable”意为“寓言”,是在神话基础上经过雕琢、赋予道德规范、适合大众传播的版本。这恰恰揭示了这两款模型最深层的秘密:它们拥有完全相同的“大脑”(底层基础模型),唯一的区别在于“灵魂”(安全与对齐策略) 。
Mythos 5 是那个被束缚的“泰坦神”。它的能力最为完整,尤其在网络安全、生物研究等高风险领域展现出了令人不安的强大实力。正因为“强到不敢全给”,Mythos 5 并未对公众开放,仅授权给经过严格审核的机构用于安全防御和前沿科研 。
而 Fable 5,正是我们今天要剖析的主角。它是那个走进凡间的“普罗米修斯”,将神话级的能力封装在了符合现代商业伦理和法规的“安全壳”中,向全球用户开放。理解了这层“同根异体”的关系,你就掌握了读懂 Fable 5 的钥匙。
2. 核心引擎:“自适应思考”的技术飞跃
如果说 Claude 3 和 4 系列是在“知识储备”上做文章,那么 Claude 5 则是在 “认知策略” 上进行了重构。其最核心的技术突破,是一个名为 自适应思考 的推理机制 。
在以往的模型中,无论是 GPT 还是 Claude 3,它们的工作模式往往是“输入-计算-输出”的单向流程。面对“1+1=?”和“如何证明哥德巴赫猜想?”,模型调用的计算资源其实是差不多的,这导致了计算资源的浪费,或者在简单任务上因过度思考而产生“幻觉”。
Fable 5 引入了一种动态计算架构。它会在生成正式回答前,先进行一个极快的“元认知”评估。
原理解析:动态计算图
传统大模型的推理消耗通常与生成长度 L 成正比,且计算量较为恒定。Fable 5 的自适应机制引入了一个复杂度系数 C(x)。
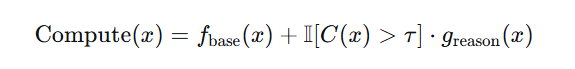
- 快速通道:当模型识别出这是一个简单指令时,它直接生成答案,延迟极低,类似于人类的“肌肉记忆”。
- 深度推理通道:当遇到复杂逻辑、数学或代码任务时,模型会在内部生成一串不可见的“思维链”。这串“思维链”甚至可以在调用外部工具(如代码解释器)的间隙中“穿插思考”,而不是等待工具返回结果后再发呆。
这种机制带来了一个显著的变化:你会感觉 Fable 5 在“思考”,而不是在“背诵”。在 SWE-Bench Pro 测试中,Fable 5 拿下了 80.3% 的得分,相比 Opus 4.8 的 69.2% 有了巨大提升,这主要归功于其在长周期任务中的自我纠错和自我规划能力 。
代码实现:API 调用新范式
对于开发者而言,接入 Fable 5 最直观的变化在于 API 参数。旧版的 budget_tokens(预算思考长度)被废弃,取而代之的是 adaptive 模式。
以下是一段最小化的调用示例(基于 Anthropic Python SDK):
from anthropic import Anthropic

client = Anthropic(api_key="YOUR_API_KEY")

response = client.messages.create(
    model="claude-fable-5",
    max_tokens=32000,  # 建议设置较大的输出空间,以适应长链推理
    thinking={"type": "adaptive"},  # 开启自适应思考
    messages=[
        {"role": "user", "content": "请分析这个代码库的结构,并找出潜在的内存泄漏点。[附代码]"}
    ]
)

# 响应将包含思考过程和最终答案
print(response.content)
关键点解读:
- 不需要指定思考强度:模型自己会判断。如果你仍想干预,可以通过
effort参数(如high,max)来引导,但adaptive是推荐用法 。 - 交错思考:在 Agent 工作流中,Fable 5 能在执行
tool_calls后,针对工具返回的结果立即进行下一步推理,无需用户手动再次发起请求。
3. 工程与商业价值的平衡:从“陪聊”到“干活”
为什么 Fable 5 的发布引发了硅谷的震动?不仅仅是因为它的分数高,更是因为它定义了 “AI 生产力” 的新标准。
3.1 Agentic 能力的质变
以前的模型更像是一个“高级顾问”——你问一句,它答一句,虽然答案精辟,但活还得你自己干。Fable 5 则进化为“实习生主管”——你可以交给它一个包含 5000 万行代码的仓库,下达指令:“把这里的旧框架迁移到新架构”。
根据支付巨头 Stripe 的早期测试,Fable 5 在一天内完成的 Ruby 代码迁移工作,相当于一个工程师团队两个月的工作量 。这种量级的效率提升,意味着 AI 开始真正渗透进核心工程的 “执行层”。
3.2 视觉与空间的“降维打击”
Fable 5 的多模态能力被显著增强了。它不仅能看图识字,还能进行 “空间推理”。在 Blueprint-Bench 2 测试中,Fable 5 得分 38.6%,远超 Opus 4.8 的 14.5% 。
这意味着它可以像人类一样看图纸。你可以上传一张 UX 设计师画的“火柴盒”级别的手绘草图,Fable 5 能直接将其转化为一个像素级还原的 React 前端代码。这种从“视觉像素”直接映射到“逻辑代码”的能力,极大地缩短了从产品构思到上线的距离。
3.3 高昂的定价逻辑
Fable 5 的定价是:输入 $10/M token,输出 $50/M token,是 Opus 4.8 的两倍 。很多个人开发者可能会觉得“用不起”。
但从商业逻辑看,这一定价非常精明。Fable 5 瞄准的是 “一次性解决复杂问题”。
以下是成本效益对比表,你可以直观看到差距:
| 特性 | Claude Opus 4.8 | Claude Fable 5 |
|---|---|---|
| 定位 | 旗舰级推理 | 神话级 Agent |
| 输出价格 | $25 / M token | $50 / M token |
| 任务模式 | 单轮问答、短链推理 | 多日规划、长程自治 |
| 代码迁移案例 | 需人工分解步骤 | 一步到位,自动验证 |
| 幻觉率 | 较低 | 极低(内置自反思机制) |
简而言之,虽然单价翻倍,但完成同一个复杂项目(如重构架构),Fable 5 消耗的总 Token 数可能反而更少,因为它在内部已经完成了大量的推演和试错,不再需要你来来回回地“喂”上下文 。
4. 戴着镣铐的舞蹈:安全护栏的技术代价
Fable 5 之所以是“寓言”而非“神话”,是因为它被强制戴上了 宪法分类器 。
这是一个不得不提的技术设计。Anthropic 的研究表明,Mythos 5 的底层模型具备极强的“双用途”潜力——它能设计出新型蛋白质,也能挖掘出操作系统未曾公开的零日漏洞。为了让 Fable 5 能够安全地面向大众,Anthropic 在模型之上架设了一个 “流量监控系统”。
技术机制:输入输出滤波器
当你的请求发送给 Fable 5 时,首先会经过一个轻量级的高效分类器。如果在 网络安全、生物武器 或 模型蒸馏(防止其他公司盗用 Fable 5 的输出来训练竞品模型)这些敏感维度上命中,系统会进行 静默降级 。
这意味着,你以为你在和最强的大脑 Fable 5 对话,但实际上你的请求已经被悄悄路由到了能力稍弱但更安全的 Claude Opus 4.8 进行处理。这种设计虽然在技术上是优雅的(避免了模型本身的参数被篡改),但在用户体验上造成了一种“认知断层”——你有时会发现 Fable 5 突然“变笨”了,其实是因为它触发了安全网。
结语
Claude Fable 5 的出现,标志着大模型竞争进入了 “认知深度” 与 “工程安全” 的双轨竞赛。它不再执着于在你手机的聊天框里写出更华丽的散文,而是致力于在你公司的服务器里,作为一名不知疲倦的“数字员工”,完成那些需要数天甚至数周才能搞定的复杂工程。
当然,它依然存在缺陷:触发了安全护栏时的“卡顿感”,以及对于个人开发者来说高昂的使用成本。但不可否认,Fable 5 向我们展示了通往 AGI 的一条务实路径——让机器像人类专家一样思考,并戴上道德与法律的手套去工作。