图像超分代码BasicSR库代码分析
图像超分代码BasicSR库代码分析
BasicSR
BasicSR目录结构
./
├── assets
├── basicsr       # 框架代码
├── colab
├── datasets
├── docs
├── experiments    # 模型
├── inference      # 推理
├── LICENSE
├── MANIFEST.in
├── options         # 配置入口 yml
├── README_CN.md
├── README.md
├── requirements.txt
├── scripts
├── setup.cfg
├── setup.py
├── tb_logger
├── tests            # 单元测试
└── VERSION
框架代码
./
├── archs              # 网络结构     arch.py	basicsr/archs/srresnet_arch.py
├── data               # 数据 dataloader 降质方法等 data/paired_image_dataset.py
├── __init__.py
├── losses             # loss
├── metrics            # 评估
├── models             # 模型训练相关定义,如优化器,loss,训练策略等 _model.py	basicsr/models/sr_model.py
├── ops                # 扩展层
├── test.py            # 测试入口
├── train.py           # 训练入口
├── utils
└── version.py
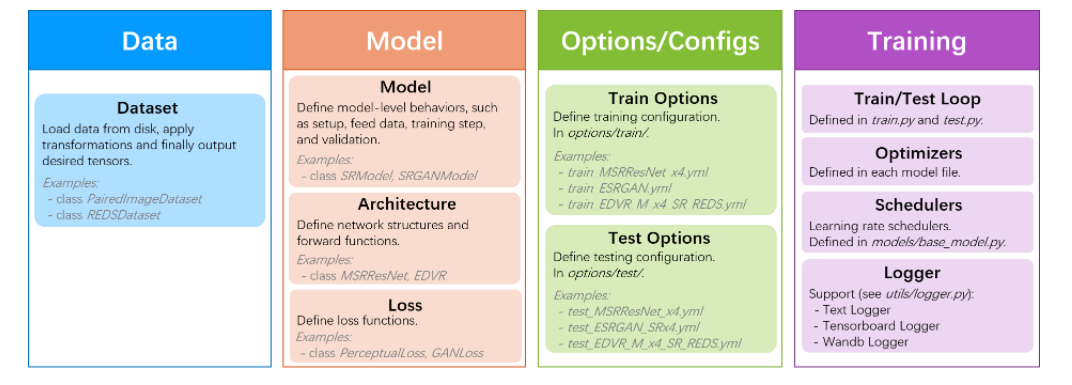
调用示例
cd BasicSR
PYTHONPATH="./" CUDA_VISIBLE_DEVICES=0 python basicsr/train.py -opt options/train/RCAN/train_RCAN_x2.yml
配置一览
使用的是yaml配置, 支持dict list等,典型的每一层级是key,:之后是value。多个层级可以理解为嵌套dict,opt['datasets]['train']['name'] == DIV2K
# TODO
# general settings
name: 201_RCANx2_scratch_DIV2K_rand0
model_type: SRModel
scale: 2
num_gpu: 1  # set num_gpu: 0 for cpu mode
manual_seed: 10

# dataset and data loader settings
datasets:
  train:
    name: DIV2K
    type: PairedImageDataset
    dataroot_gt: /cache6/SR/SR_DATA/DIV2K/DIV2K_train_HR
    dataroot_lq: /cache6/SR/SR_DATA/DIV2K/DIV2K_train_LR_bicubic/X2
    # (for lmdb)
    # dataroot_gt: datasets/DIV2K/DIV2K_train_HR_sub.lmdb
    # dataroot_lq: datasets/DIV2K/DIV2K_train_LR_bicubic_X2_sub.lmdb
    filename_tmpl: '{}'
    io_backend:
      type: disk
      # (for lmdb)
      # type: lmdb

    gt_size: 96
    use_flip: true
    use_rot: true

    # data loader
    use_shuffle: true
    num_worker_per_gpu: 6
    batch_size_per_gpu: 16
    dataset_enlarge_ratio: 100
    prefetch_mode: ~

  val:
    name: Set5
    type: PairedImageDataset
    dataroot_gt: /cache6/SR/SR_DATA/Set5/HR
    dataroot_lq: /cache6/SR/SR_DATA/Set5/LRX2
    io_backend:
      type: disk

# network structures
network_g:
  type: RCAN
  num_in_ch: 3
  num_out_ch: 3
  num_feat: 64
  num_group: 10
  num_block: 20
  squeeze_factor: 16
  upscale: 2
  res_scale: 1
  img_range: 255.
  rgb_mean: [0.4488, 0.4371, 0.4040]

# path
path:
  pretrain_network_g: ~
  strict_load_g: true
  resume_state: ~

# training settings
train:
  optim_g:
    type: Adam
    lr: !!float 1e-4
    weight_decay: 0
    betas: [0.9, 0.99]

  scheduler:
    type: MultiStepLR
    milestones: [200000]
    gamma: 0.5

  total_iter: 300000
  warmup_iter: -1  # no warm up

  # losses
  pixel_opt:
    type: L1Loss
    loss_weight: 1.0
    reduction: mean

# validation settings
val:
  val_freq: !!float 5e3
  save_img: false

  metrics:
    psnr: # metric name, can be arbitrary
      type: calculate_psnr
      crop_border: 2
      test_y_channel: false

# logging settings
logger:
  print_freq: 100
  save_checkpoint_freq: !!float 5e3
  use_tb_logger: true
  wandb:
    project: ~
    resume_id: ~

# dist training settings
dist_params:
  backend: nccl
  port: 29500
简单拆解 train.py
# 读取配置
opt = parse_options(root_path, is_train=True)
# 日志logger
logger, tb_logger = init_loggers(opt)

# 加载数据dataloader
result = create_train_val_dataloader(opt, logger)
train_loader, train_sampler, val_loader, total_epochs, total_iters = result
prefetcher = CPUPrefetcher(train_loader)


# 构建模型(网络,优化器, loss)
model = build_model(opt)

# 开始训练(batch data, 更新学习率,梯度反向传播,)
for epoch in range(start_epoch, total_epochs + 1):
    train_sampler.set_epoch(epoch)
    prefetcher.reset()
    train_data = prefetcher.next()

    while train_data is not None:
        data_time = time.time() - data_time

        current_iter += 1
        if current_iter > total_iters:
            break
        # update learning rate
        model.update_learning_rate(current_iter, warmup_iter=opt['train'].get('warmup_iter', -1))
        # training
        model.feed_data(train_data)
        model.optimize_parameters(current_iter)
关键点: 根据配置名称来动态实例化
-
basicsr/utils/registry.py
class Registry(): def register(self, obj=None): """ Register the given object under the the name `obj.__name__`. Can be used as either a decorator or not. See docstring of this class for usage. """ if obj is None: # used as a decorator def deco(func_or_class): name = func_or_class.__name__ self._do_register(name, func_or_class) return func_or_class return deco DATASET_REGISTRY = Registry('dataset') ARCH_REGISTRY = Registry('arch') MODEL_REGISTRY = Registry('model') LOSS_REGISTRY = Registry('loss') METRIC_REGISTRY = Registry('metric') -
定义模型 basicsr/models/sr_model.py
@MODEL_REGISTRY.register() class SRModel(BaseModel): pass -
basicsr/models/init.py
./models
├── base_model.py
├── edvr_model.py
├── esrgan_model.py
├── lr_scheduler.py
├── srgan_model.py
├── sr_model.py
├── stylegan2_model.py
├── video_base_model.py
└── video_gan_model.py
import importlib from copy import deepcopy from os import path as osp from basicsr.utils import get_root_logger, scandir from basicsr.utils.registry import MODEL_REGISTRY __all__ = ['build_model'] # automatically scan and import model modules for registry # scan all the files under the 'models' folder and collect files ending with # '_model.py' model_folder = osp.dirname(osp.abspath(__file__)) model_filenames = [osp.splitext(osp.basename(v))[0] for v in scandir(model_folder) if v.endswith('_model.py')] # import all the model modules _model_modules = [importlib.import_module(f'basicsr.models.{file_name}') for file_name in model_filenames] def build_model(opt): """Build model from options. Args: opt (dict): Configuration. It must constain: model_type (str): Model type. """ opt = deepcopy(opt) model = MODEL_REGISTRY.get(opt['model_type'])(opt) logger = get_root_logger() logger.info(f'Model [{model.__class__.__name__}] is created.') return model