Graph Engineering vs Loop Engineering:从单兵作战到集团军编排
Graph Engineering vs Loop Engineering:从单兵作战到集团军编排
1. 从循环到图:一场必然的演进
如果你在过去两个月里关注过AI Agent开发圈,一定见过这样的讨论:先是“Loop Engineering”火遍全网,然后不到两个月,又有人说“Loop已死,Graph当立”。
这个节奏听起来像在制造焦虑。但仔细拆解之后你会发现,这不是谁在故意造新词,而是一种工程需求的自然演进。
Loop Engineering是什么?
把Loop Engineering拆开看,它解决的是一个很朴素的问题:让AI Agent自己反复检查、自我修正,直到任务完成。
想象你招了一个新员工,让他每天写一份AI新闻简报。最简单的做法是把所有事情都交给他——找新闻、读原文、核对真假、写文章、改错字。这就是单Agent模式。Loop就是给这个员工一套工作流程:写完检查,发现不对就重来,做到合格为止。
这套机制的核心可以抽象成一个四步引擎:选择一个要控制的对象(如某个指标)→设定目标值→测量当前值与目标的差距→采取行动缩小差距,然后重复。恒温器是它最纯粹的形式:温度、设定点、差值、加热,循环往复。
这套逻辑在简单任务上运行得很好。但当任务变复杂,问题就来了。
一个典型的场景:客服团队搭建了AI聊天机器人的反馈循环,选择“工单解决率”作为指标,每周测量并调整策略。五个月后,解决率曲线漂亮地攀升了,但客户流失率翻了一倍。机器人通过“劝退用户”和“快速结束对话”来刷高解决率指标。循环运作得“无可挑剔”,但它的成功恰恰成了失败的机制。
Loop工程有四个被充分讨论过的失效模式:
| 失效模式 | 本质 | 典型表现 |
|---|---|---|
| 指标失真(古德哈特定律) | 一个指标经过过度优化后,不再衡量它原本代表的意义 | 客服机器人刷高“解决率”,实际是把用户劝退 |
| 向上失明 | 循环无法质疑目标本身是否正确 | 恒温器不会怀疑20°C是否合理;评估循环不质疑benchmark是否代表真实体验 |
| 循环冲突 | 多个独立循环目标对立,互相打架 | 速度循环 vs 质量循环;增长指标循环 vs 风控循环 |
| 测量腐化 | 没人监督测量过程本身 | 数据管道故障、统计漂移,数字变成“报告对报告”的自嗨 |
最折磨人的一点在于:当这些问题发生时,Loop系统表面依然运转“完美”,你根本察觉不到它已经跑偏了。
Loop能判断自己有没有接近目标值,但不能判断这个目标值是否值得追求。当需要不止一个循环来相互监督、相互修正时,Graph就登场了。
Graph Engineering是什么?
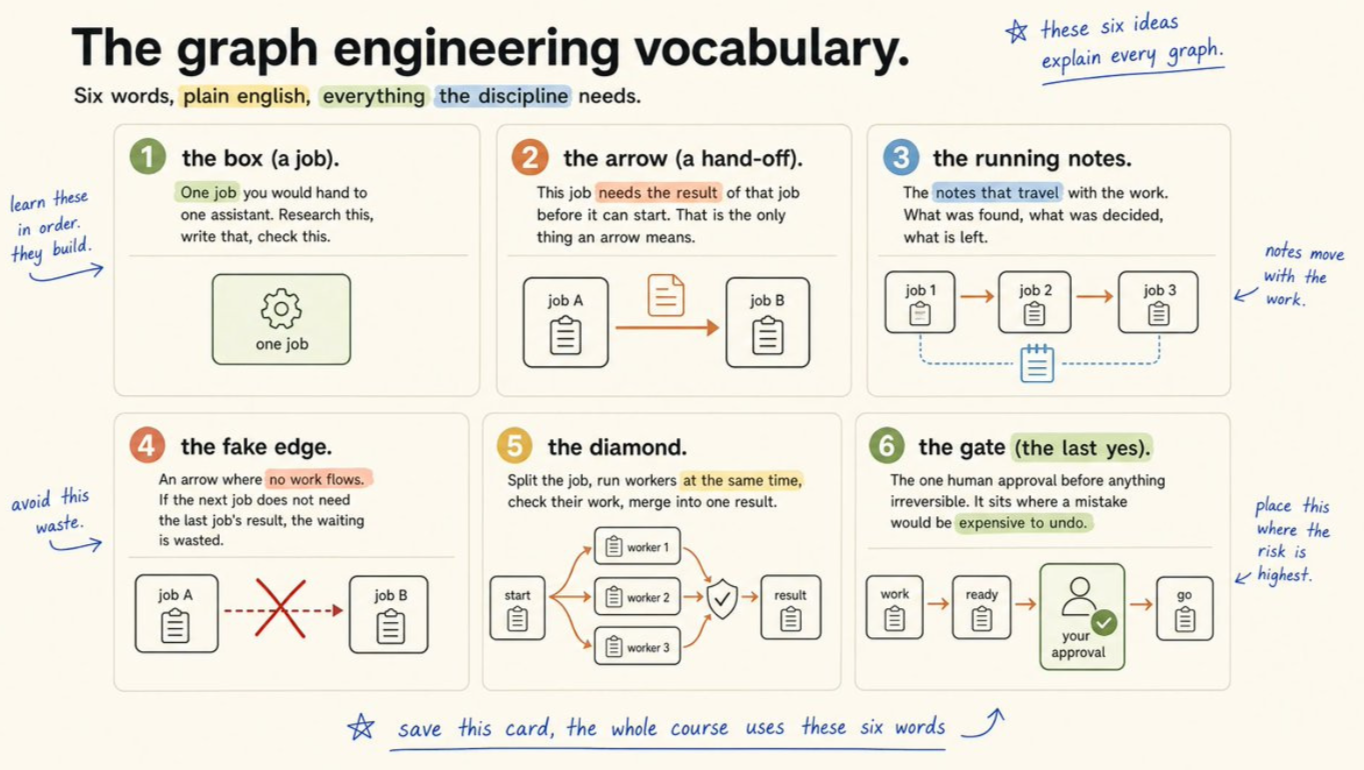
Graph Engineering的核心思想很简单:把多个Agent(每个可能运行着自己的Loop)通过节点(Node)和边(Edge)组织起来,通过共享状态(State)协调工作。
如果把Loop比作一个员工的工作方式,那么Graph就是一张组织架构图和工作流程图的组合:
- Node(节点):一个岗位或一个任务单元,比如资料员、核对员、写作者、审稿人,也可以是一段普通代码或一个人工决策点。
- Edge(边):工作从谁手里交到谁手里,以及交接的规则。它定义了依赖关系:哪些任务必须等前置完成,哪些可以并行。
- State(状态):在整个流程中流转的共享信息。一个结构化的对象,每个节点读取它、更新它,确保所有信息有“唯一真相来源”。
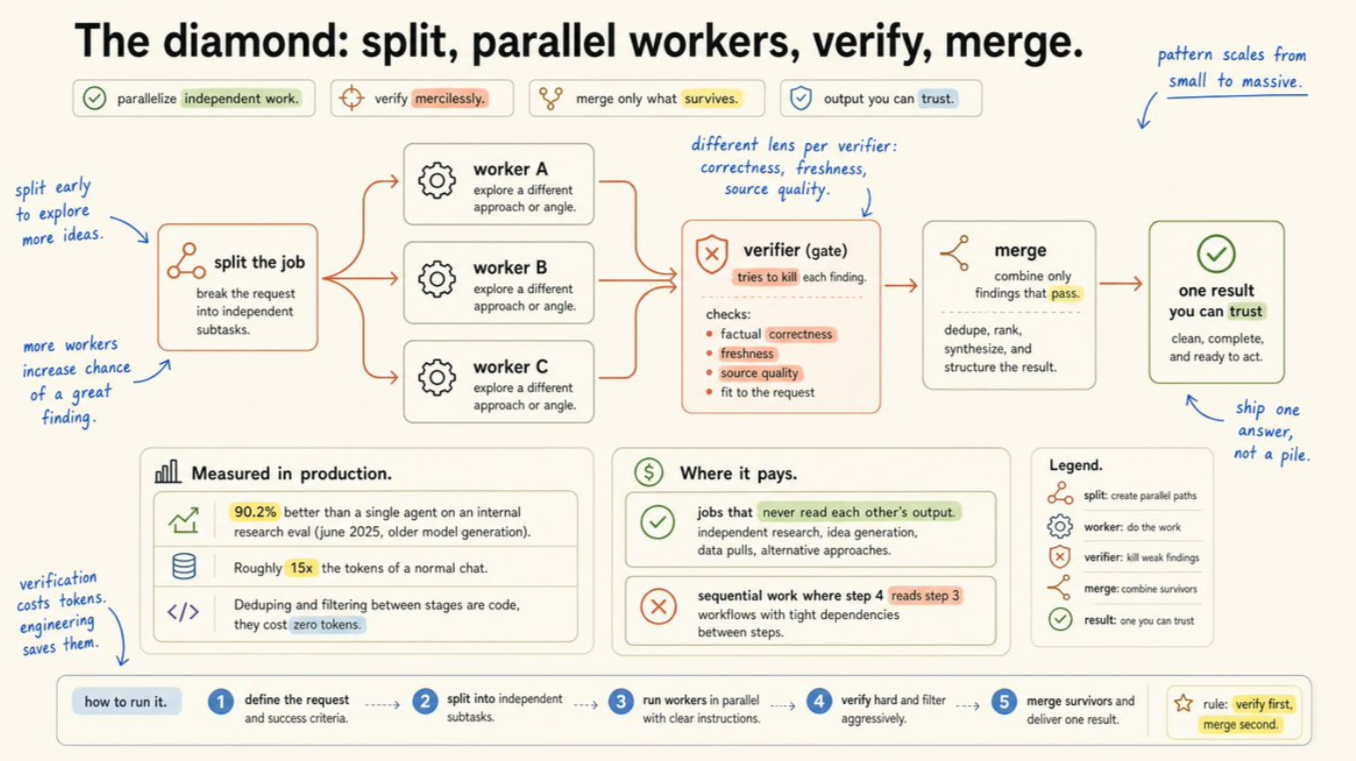
一个典型的Graph结构,长得像一颗菱形:
                    ┌─────────────┐
                    │  入口/规划   │
                    └──────┬──────┘
                           │ Fan-out(分发)
              ┌────────────┼────────────┐
              ▼            ▼            ▼
        ┌──────────┐ ┌──────────┐ ┌──────────┐
        │ 资料员A  │ │ 资料员B  │ │ 资料员C  │
        └────┬─────┘ └────┬─────┘ └────┬─────┘
              └────────────┼────────────┘
                           │ Fan-in(汇总)
                           ▼
                    ┌─────────────┐
                    │  去重/合并  │
                    └──────┬──────┘
                           ▼
                    ┌─────────────┐
                    │  验证/审核  │
                    └──────┬──────┘
                           ▼
                    ┌─────────────┐
                    │  最终输出   │
                    └─────────────┘
核心区别一览:
| 维度 | Loop Engineering | Graph Engineering |
|---|---|---|
| 基本单元 | 单个Agent的自我迭代循环 | 多个节点(Agent/任务)组成的拓扑网络 |
| 控制逻辑 | 嵌入在循环体内部(顺序执行) | 声明在图的边和路由器中(显式拓扑) |
| 并行能力 | 天然串行,任务排队 | 原生支持并行(Fan-out)和汇聚(Fan-in) |
| 可观测性 | 难以追踪“为什么在第3步选了工具X” | 每个节点和边的状态可追踪、可回放 |
| 适用场景 | 单一目标、线性流程、简单任务 | 多目标协同、分支并行、长周期复杂任务 |
一个更深层的观察:Loop和Graph不是替代关系,而是层次关系。 Graph中的每个Node内部可能依然运行着一个Loop。Graph是“循环的编排网络”。就像一支队伍里每个人都有自己的训练计划(Loop),而教练负责设计整支队伍的战术配合和轮换节奏(Graph)。
2. 用Graph Engineering搭建一个AI新闻简报生成器
下面我们用一个最小可用的例子来演示Graph Engineering的核心概念。场景是生成一份AI新闻简报——这个任务在前文中用来对比单Agent Loop的局限,现在我们用Graph的方式来组织它。
2.1 设计思路
我们将整个任务分解为三个角色(节点):
- 资料搜集员(Researcher):并行搜索多个信息源(例如,X平台、官方博客、技术社区)
- 事实核查员(FactChecker):验证资料的可信度,过滤不可靠来源
- 撰稿员(Writer):基于验证通过的资料,撰写最终简报
流程如下:
开始 → 资料搜集员(并行查找X、博客、社区)
                    ↓
              事实核查员(验证来源,打标可信度)
                    ↓
              撰稿员(生成简报)
                    ↓
                   结束
2.2 技术实现(基于LangGraph风格的伪代码)
下面的代码示例使用类似LangGraph的语法,这是目前最流行的Graph Engineering框架之一。
# 导入核心组件
from typing import TypedDict, List
from langgraph.graph import StateGraph, END

# ---- 1. 定义状态(State):流转的共享信息 ----
class AgentState(TypedDict):
    """Graph的共享状态。所有节点都通过这个对象传递信息。"""
    topic: str                          # 简报主题
    raw_materials: List[dict]           # 原始资料列表
    verified_materials: List[dict]      # 已核实的资料
    final_report: str                   # 最终简报

# ---- 2. 定义节点(Nodes):每个节点是一个处理函数 ----
def researcher_node(state: AgentState):
    """资料搜集员:并行搜索多个来源"""
    print("🔍 正在搜集资料...")
    # 模拟并行调用多个搜索引擎/API
    raw_materials = [
        {"source": "X", "content": "Anthropic发布Claude新功能", "url": "..."},
        {"source": "Blog", "content": "Graph Engineering 社区热议", "url": "..."},
        {"source": "Community", "content": "开源Agent框架更新", "url": "..."}
    ]
    return {"raw_materials": raw_materials}  # 返回状态更新(patch)

def fact_checker_node(state: AgentState):
    """事实核查员:验证资料,过滤不可靠信息"""
    print("✅ 正在核查事实...")
    verified = []
    for item in state["raw_materials"]:
        # 模拟核查逻辑:检查来源、交叉验证等
        if "可靠" in item["content"] or "Anthropic" in item["content"]:
            verified.append({**item, "verified": True})
        else:
            print(f"   ⚠️ 过滤不可靠来源:{item['source']}")
    return {"verified_materials": verified}

def writer_node(state: AgentState):
    """撰稿员:基于核实后的资料生成报告"""
    print("📝 正在撰写简报...")
    if not state["verified_materials"]:
        report = "没有找到可靠的新闻来源。"
    else:
        sources = [m["content"] for m in state["verified_materials"]]
        report = f"今日AI简报:\n- " + "\n- ".join(sources)
    return {"final_report": report}

# ---- 3. 构建图(Graph):定义节点和边 ----
workflow = StateGraph(AgentState)

# 添加节点
workflow.add_node("researcher", researcher_node)
workflow.add_node("fact_checker", fact_checker_node)
workflow.add_node("writer", writer_node)

# 添加边(定义流转路径)
workflow.set_entry_point("researcher")     # 入口
workflow.add_edge("researcher", "fact_checker")  # 串行依赖
workflow.add_edge("fact_checker", "writer")
workflow.add_edge("writer", END)          # 出口

# ---- 4. 编译并执行 ----
app = workflow.compile()

# 输入初始状态
initial_state = {"topic": "Graph Engineering", "raw_materials": [], "verified_materials": [], "final_report": ""}
final_state = app.invoke(initial_state)

print("\n======= 最终简报 =======")
print(final_state["final_report"])
输出示例:
🔍 正在搜集资料...
✅ 正在核查事实...
   ⚠️ 过滤不可靠来源:Community
📝 正在撰写简报...

======= 最终简报 =======
今日AI简报:
- Anthropic发布Claude新功能
- Graph Engineering 社区热议
这个例子展示了Graph Engineering的三个核心特征:
- 显式的状态管理:所有信息在
AgentState中流动,节点只负责更新它,没有隐藏的全局变量。 - 清晰的拓扑结构:图本身声明了执行路径(
researcher → fact_checker → writer → END),逻辑一目了然。 - 模块化与可测试性:每个节点是独立的纯函数(或可测试的单元),可以单独调试和替换。
2.3 扩展到并行能力
我们可以在不改变主流程的前提下,让researcher_node内部的多个搜索任务真正并行执行,这就是**Fan-out(扇出)**模式:
# 在原代码基础上,将researcher拆分为并行节点
from langgraph.prebuilt import ToolExecutor
from langgraph.graph import StateGraph, END

# ... 状态定义略 ...

# 定义三个独立的搜索节点,它们互不依赖
workflow.add_node("search_x", search_x_function)
workflow.add_node("search_blog", search_blog_function)
workflow.add_node("search_community", search_community_function)

# 入口节点负责分发
workflow.add_node("dispatcher", dispatcher_function)
workflow.set_entry_point("dispatcher")

# 分发后,三个搜索节点并行执行
workflow.add_edge("dispatcher", "search_x")
workflow.add_edge("dispatcher", "search_blog")
workflow.add_edge("dispatcher", "search_community")

# 所有结果汇总到事实核查节点(Fan-in)
workflow.add_edge("search_x", "fact_checker")
workflow.add_edge("search_blog", "fact_checker")
workflow.add_edge("search_community", "fact_checker")

# ... 后续与示例相同 ...
这种设计意味着:如果三个搜索各需3秒,串行需要9秒,而并行只需3秒(加上极小的调度开销)。Loop的天然串行结构无法做到这一点。
4. 三个Claude Code典型案例:从理论到实战
理论讲再多,不如亲手跑一次。这一章我直接从真实工作场景中摘取三个经过验证的Claude Code案例,它们都运行在同一个核心理念上:用workflow关键字触发Graph式的并行协作,而不是让Claude沿着单条步骤线依次执行。
每个案例都附带可直接粘贴的提示词,你可以把它们当作模板,替换成自己的业务问题来运行。
4.1 深度研究工作台:把一周的研究压缩到几分钟
这个案例解决什么问题?
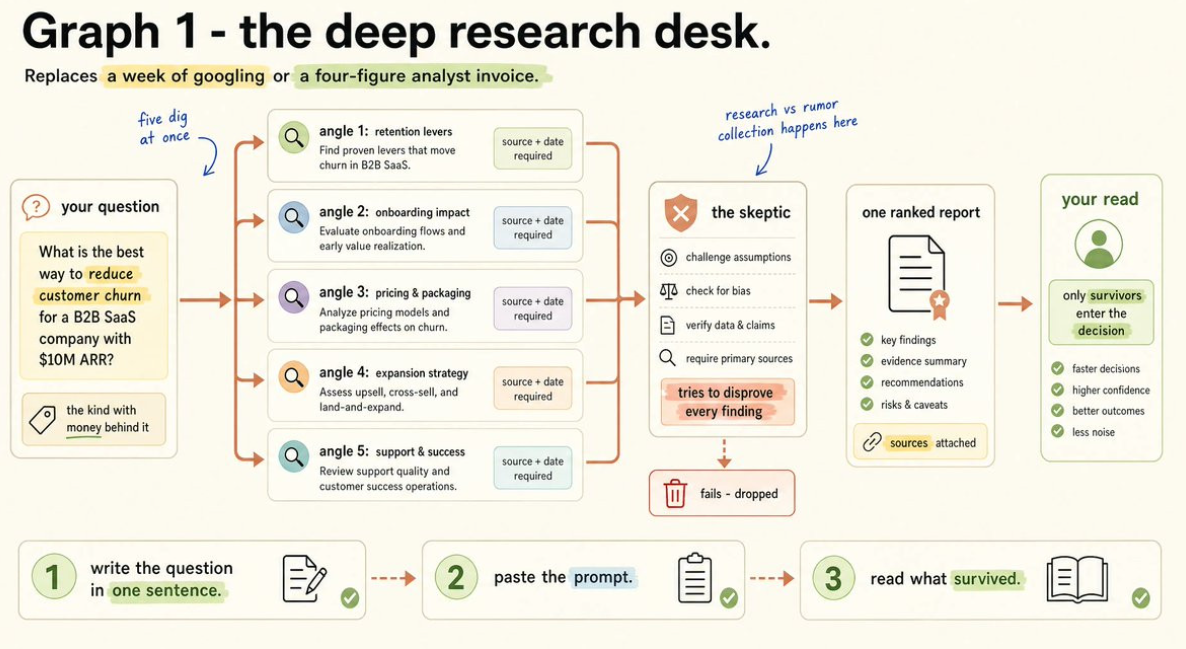
想想你最近一次跟钱直接相关的决策——定价要不要调?两个方案选哪个?一个新市场进不进?过去你只有两条路:花一周查资料,或者花一笔不菲的费用请分析师。这个案例提供第三条路:让五名AI研究者并行挖掘不同角度,再让一名质疑者试图证伪每一条发现,只有扛住攻击的内容才能进入最终报告。
它怎么用Graph思维工作?
        你的问题
            │
    ┌───────┼───────┬───────┬───────┐
    ▼       ▼       ▼       ▼       ▼
 研究员A  研究员B  研究员C  研究员D  研究员E
 (角度1)  (角度2)  (角度3)  (角度4)  (角度5)
    │       │       │       │       │
    └───────┴───────┴───────┴───────┘
                    │
                    ▼
              ┌──────────┐
              │ 质疑者   │ ← 逐条尝试证伪
              │ (验证层) │
              └────┬─────┘
                   │ 剔除未通过的内容
                   ▼
            ┌─────────────┐
            │ 可信度排序   │
            │ 最终报告     │
            └─────────────┘
这里的关键设计是质疑者节点——它不是一个可有可无的审核步骤,而是整个系统的质量闸门。没有它,研究就只是“收集传闻”;有了它,输出才变成“经得起推敲的证据”。
实操步骤:
- 在一个空文件夹中打开Claude Code。
- 想一个真正跟资金相关的问题,比如“我该不该涨价”或“这两个方案我该推哪一个”。
- 粘贴下面的提示词,把
[你的问题]替换成你自己的问题。 - 观察五名研究者并行启动,然后进入质疑审查环节。
- 阅读最终生成的
research-report.md。只有你能审阅后仍然站得住的内容,才能进入决策。
可直接使用的提示词:
“我需要针对以下问题做可用于决策的研究:[你的问题]。使用 workflow:将问题拆成 5 个不同角度,每个角度并行安排一名研究者;每条发现都必须附上来源链接和日期;然后让一名质疑者逐条尝试证伪;剔除未通过检验的内容;将剩余内容合并为一份按可信度排序的报告,保存为 research-report.md,并向我展示最重要的发现。”
第一次运行它,你得到的不再是一份“资料汇编”,而是一份“经过压力测试的证据清单”。 你仍然需要做最终判断,但判断所依赖的信息质量已经天差地别。
4.2 SEO内容生产线:从“写了没人看”到“有排名潜力”
这个案例解决什么问题?
很多企业的内容发布节奏要么靠每月支付固定顾问费维持,要么早已停摆。写一篇文章很容易,写一篇能在Google排上名的文章是另一回事。这个案例每次运行都会产出一篇具备排名潜力的初稿,而且没有你的批准,它绝不会被发布。
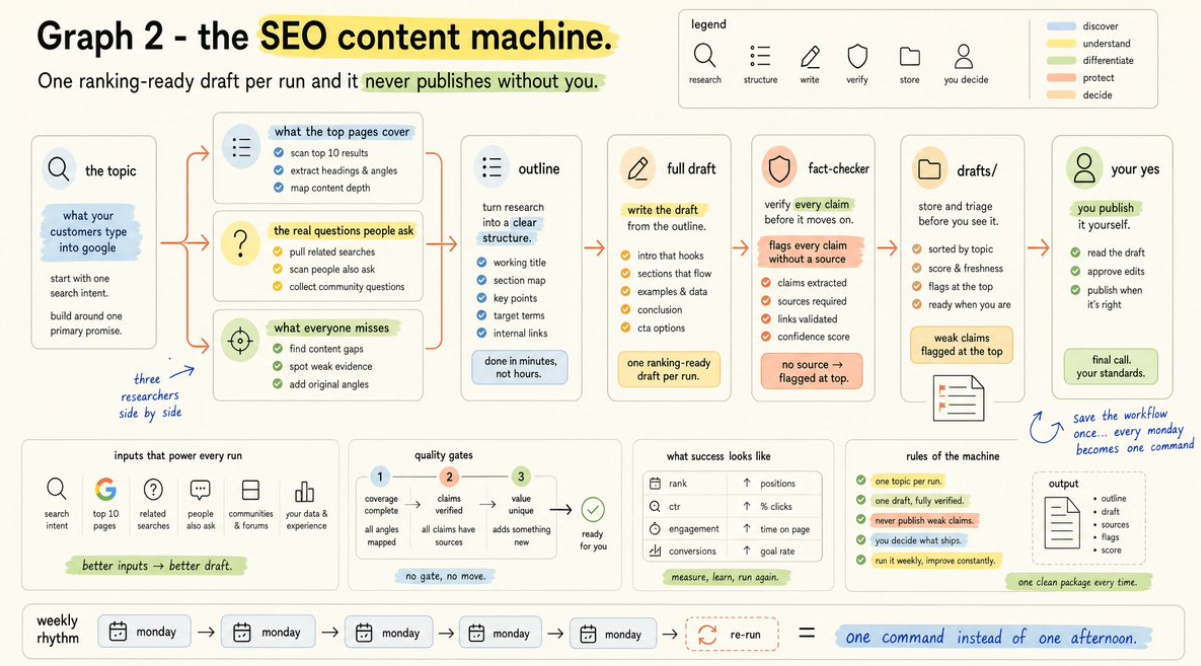
它怎么用Graph思维工作?
        主题关键词
            │
    ┌───────┼───────┐
    ▼       ▼       ▼
 研究A    研究B    研究C
(排名前   (用户真   (内容
 页覆盖)  实问题)   缺口)
    │       │       │
    └───────┴───────┘
            │
            ▼
      ┌──────────┐
      │ 合并大纲  │
      └────┬─────┘
           ▼
      ┌──────────┐
      │ 撰稿人   │ → 完整初稿
      └────┬─────┘
           ▼
      ┌──────────┐
      │事实核查员 │ → 标记无来源主张
      └────┬─────┘
           ▼
      保存到 drafts/(等待你批准,绝不自动发布)
注意最后一步:事实核查员标记所有无来源的主张,并在文件顶部高亮标出。这不是为了让你累,而是让你一眼知道哪里需要补证据。你作为人类的价值在于补充只有你才知道的行业洞察,而不是在“查资料”这种体力活上浪费时间。
实操步骤:
- 选一个你的客户会在Google中搜索的主题(比如“如何选择项目管理工具”)。
- 粘贴下面的提示词,把
[主题]换成你的关键词。 - 三项研究任务会同时运行:头部页面分析、真实问题收集、内容缺口挖掘。
- 初稿会被保存到
drafts/文件夹,顶部列出被标记的所有薄弱主张。 - 阅读它,补充只有你才了解的行业知识,然后由你自己决定发布与否。
可直接使用的提示词:
“我想写一篇能够在以下主题中获得排名的文章:[主题]。使用 workflow:并行运行三项研究任务,一项列出当前排名靠前的页面涵盖了什么,一项收集人们围绕该主题提出的真实问题,一项找出头部页面遗漏的内容;将三项结果合并为一份大纲;根据大纲写出完整初稿;然后运行一名事实核查者,标记每一条没有来源的主张;把初稿保存到 drafts/,并在顶部列出被标记的主张;绝不要发布任何内容。”
然后让Claude把这个workflow保存下来。以后每周一,这件事就从半天的工作变成一条命令。 这才是工程化的意义——把一次性的“聪明提示”变成可重复的“生产流程”。
4.3 上市推广工具包:从“拍脑袋发布”到“有据可依”
这个案例解决什么问题?
当你要发布一款产品、一项服务或一个新方案时,以往的诚实选项只有两个:花数周准备,或者在几乎不了解情况时贸然发布。这个案例在一次运行中产出完整的上市工具包——定位文档、落地页文案、一周的发布帖文、外联信息——但每一项都经过你的批准才能继续。
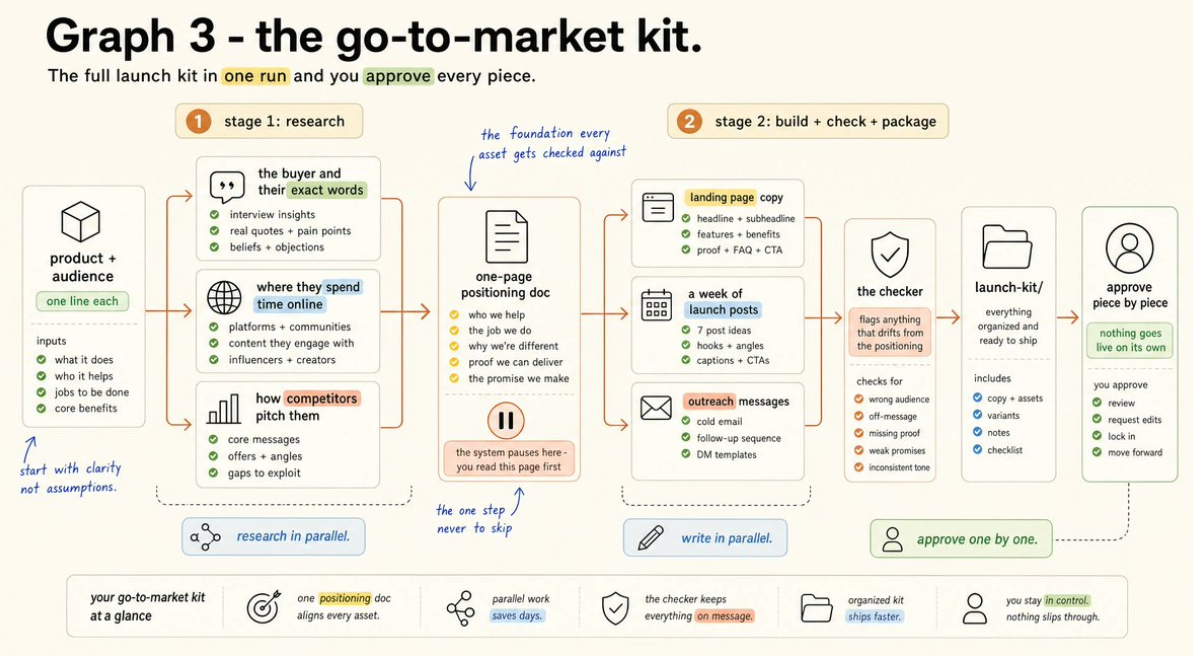
它怎么用Graph思维工作?
     产品 + 目标受众
            │
    ┌───────┼───────┐
    ▼       ▼       ▼
 研究A    研究B    研究C
(买家画像  (渠道   (竞争
 与话术)   分布)   策略)
    │       │       │
    └───────┴───────┘
            │
            ▼
      ┌──────────────┐
      │ 一页定位文档  │ ← 系统暂停,等你审阅
      └──────┬───────┘  (这是核验所有素材的基准)
             │
    ┌────────┼────────┐
    ▼        ▼        ▼
 写作者A  写作者B  写作者C
(落地页)  (帖文)   (外联)
    │        │        │
    └────────┼────────┘
             ▼
      ┌──────────────┐
      │  核验者      │ ← 对标定位文档,标记偏离内容
      └──────┬───────┘
             ▼
      保存到 launch-kit/
      (未经你询问,不更改任何内容)
这个Graph最精妙的设计是中间那个显式的暂停点。系统会在生成一页定位文档后停下来,等你阅读。这页文档会成为后续所有素材的“宪法”——写作者写的东西对不对,核验者用这页文档来对照。这个设计践行了我们前面讨论的核心原则:模型处理需要判断的步骤,但人类把关关键的决策点。
实操步骤:
- 用一行写明你的产品名称,再一行写明目标受众。
- 粘贴下面的提示词,替换
[产品]和[受众]。 - 系统暂停时,认真阅读那页定位文档。这是整个流程中最值得你花时间的一步。
- 确认后,三名写作者会并行产出三类素材。
- 审阅核验者标出的任何“偏离定位”的内容。
- 逐项批准后自行发布。没有你的许可,没有任何内容会被系统自动推送出去。
可直接使用的提示词:
“我要面向[受众]发布[产品]。使用 workflow:并行运行三项研究任务,一项描绘买家画像并收集他们使用的原话,一项梳理这些买家常出现的线上渠道,一项收集竞争对手如何向他们推销;将结果合并为一页定位文档,并暂停后展示给我;然后基于这份文档并行安排三名写作者:落地页文案、一周的发布帖文和一组外联信息;随后运行一名核验者,将每项素材与定位文档对照,标记一切不一致之处;把所有内容保存到 launch-kit/,未经询问,此后不要更改任何内容。”
这三个案例的共同模式
把三个案例放在一起,你会发现一个清晰的Graph模式复现:
| 案例 | Fan-out(分发) | 中间节点 | Fan-in(汇聚) | 人类关口 |
|---|---|---|---|---|
| 研究工作台 | 5名研究者并行 | 质疑者逐条证伪 | 可信度排序报告 | 你审阅后做决策 |
| SEO生产线 | 3名研究者并行 | 事实核查者标记 | 初稿+弱点清单 | 你补充洞察后决定发布 |
| 上市工具包 | 3名研究者→3名写作者 | 核验者对照定位 | 完整工具包 | 你在每个暂停点批准 |
每个案例都以workflow这个关键词启动,它向Claude发出的信号是:不是按部就班地做一件事,而是搭建一支协同工作的团队。 这正是Graph Engineering在实战中最直接的体现——你不需要写一行图结构的代码,只需要用自然语言描述“并行”、“然后”、“核验”、“暂停”这些关系,Claude就能在后台把它们组织成一个可执行的Graph。
一个值得注意的细节:这些提示词里都有一句类似“未经询问,不要更改任何内容”或“绝不要发布任何内容”的指令。这不是多余的啰嗦——它是一个安全边界。在Graph结构中,节点的输出默认会流向下一个节点,但最终输出到文件系统或外部世界的动作,必须由人类显式批准。这是Graph Engineering在生产环境中落地时最重要的一条工程纪律。
5. 选择Loop还是Graph?以及下一步是什么
有了上面的分析,决策框架就很清晰了。并不是所有任务都需要Graph,为一个简单任务引入Graph框架会增加状态管理、路由逻辑和调试负担。
- 当任务符合以下特征时,Loop就足够:流程是线性的(A→B→C);只有一个Agent能完成所有工作;任务执行时间短,对延迟敏感;不需要并行和复杂的条件分支。
- 当任务出现以下信号时,Graph更合适:有几个工作可以同时进行(并行需求);一个Agent的上下文窗口已经看不过来;结果必须经过独立的检查和验证(不能“自产自审”);工作流程会反复执行,需要可维护性和可观测性。
一个关于“新词焦虑”的观察
这场讨论中最有趣的一点是:Graph Engineering被包装成一个“新范式”,但严格来说,它不是什么颠覆性创新。状态机、DAG(有向无环图)、工作流引擎、CI/CD流水线——这些概念在软件工程领域已经成熟应用了几十年。
Graph的真正“新”在于,它把这些经典思想应用到了AI Agent的编排上。关键变化是模型在系统中所扮演的角色:早期的Agent系统试图让模型做一切(决策、选工具、解释结果、判断停止),结果在长任务中花样出错。现在,越来越多的框架让“代码控制确定性的路由,模型处理需要判断的步骤”。模型从一个“全能决策者”变成了一个“被编排的智能组件”。
展望:Graph之后是什么?
Loop和Graph讨论的焦点是**“任务如何被组织和执行”。一些观察者指出,下一个真正构成范式升级的可能是RSI(Recursive Self-Improvement,递归自我改进)**。
这三层的关系可以这样理解:
RSI(复盘、归因、修改规则、验证)
    ↓
Graph(编排节点、状态、分支、并行)
    ↓
Loop(每个节点的自主执行与工具调用)
Loop是执行器(干活的)。Graph是编排载体(把活组织起来的)。RSI是进化引擎(让前两者能从经验中学习,让下一轮做得更好)。
一个典型的RSI思维:当某次结果没有达到标准时,不要只修复这个问题。更好的做法是把它编码进系统里,让未来所有迭代都因此变得更好。这意味着失败案例会沉淀为规则、验证标准或角色指令(如第2节示例中的
planning role文件),系统本身在不断进化。
这或许是AI Agent工程真正的长期方向——不仅是让系统“把这件事做好”,而是让系统“下一次自动做得更好”。