测试CLIP zero-shot learning
测试CLIP zero-shot learning
1. 什么是CLIP
CLIP是OpenAI在Learning Transferable Visual Models From Natural Language Supervision提出的多模态的预训练模型,CLIP利用文本和图像的配对数据,基于对比学习的方式训练的预训练模型,对于方便迁移到下游任务,如图像分类识别,精细图像分类,OCR,动作识别和地理信息定位等等。
以往的视觉模型,都是基于一定场景下监督训练的出来的,这种受限制的监督形式限制了它们的通用性和可用性,如增加一个类别,就要重新收集数据,重新迭代模型。虽然有few-shot learning或者zero-shot learning,但是性能远不如监督学习的模型。
CLIP(Contrastive Language-Image Pre-training)用文本的监督方式,在4亿数据集上可以有效的迁移到新的任务。
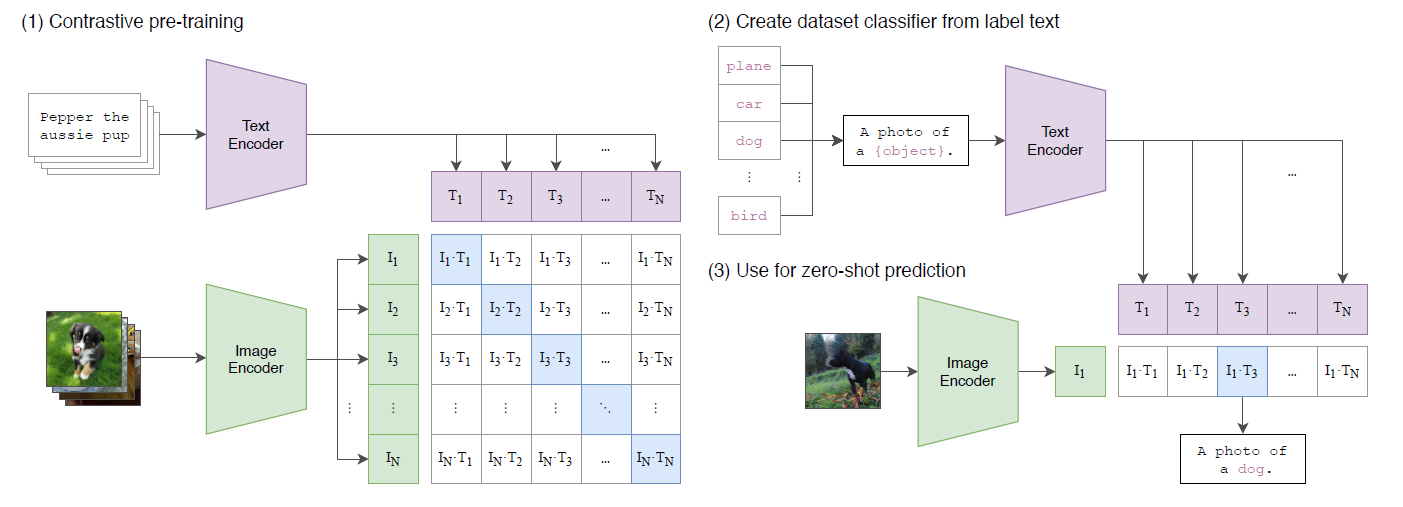
CLIP分别对文本和图像训练两个Encode模型,并用相似度度量的方式进行监督。可以构造(image, text)的配对方式,通过计算相似度来判断配对是否相关。
2. CLIP图像分类识别测试
CLIP可以用来做什么?我们用来做下图像分类的测试:
import torch
import clip
from PIL import Image

device = "cuda" if torch.cuda.is_available() else "cpu"
model, preprocess = clip.load("./ViT-B-32.pt", device=device)
image = preprocess(Image.open("./images/R-C.jpg")).unsqueeze(0).to(device)
text = clip.tokenize(["a sexy photo", "a porn photo", "a normal photo"]).to(device)

with torch.no_grad():
    image_features = model.encode_image(image)
    text_features = model.encode_text(text)

    logits_per_image, logits_per_text = model(image, text)
    probs = logits_per_image.softmax(dim=-1).cpu().numpy()

print("Label probs:", probs)
# Label probs: [[0.9614  0.02727 0.01154]]
CLIP本质上是建立文本和图像的相关性,对文本和图像进行编码。从代码可知,CLIP用在图像分类上:
- 图像分类的类别构建text,并用clip进行编码
- 对图像进行编码
- 计算图像和类别的编码的相似性
- 取相似性最大的类别
CLIP论文给出许多构建类别的文本的text,如"a photo of 《label》"
CLIP是不是可以做一个万物识别的分类模型?
3. CLIP的其他用途
CLIP建立了text和image的关系,那么CLIP可以应用的场景:
- 给图生成一个文本说明
- 以文本搜图
- 以文本生成图片,这个就是现在很多的AIGC(如DALE-2,Stable Diffusion),是在CLIP基础上加上扩散模型来生成图像
最近对CLIP优化的总结:
Democratizing Contrastive Language-Image Pre-training: A CLIP Benchmark of Data, Model, and Supervision