Machine Learning Yearning (Ng)
Machine Learning Yearning (Ng)
Author: aiweker, 微信:mintel, 欢迎交流
iweker/
1. 引言
更大的网络和更多的数据造就了深度学习良好的性能
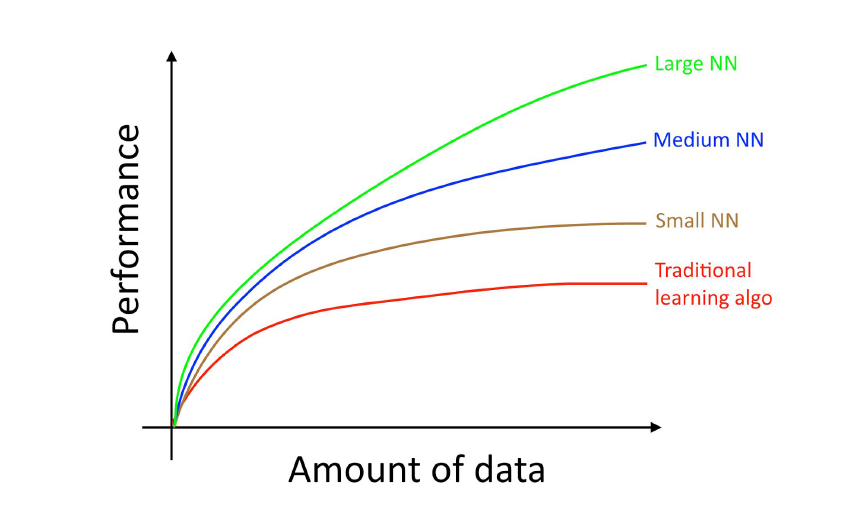
tips: one of the more reliable ways to improve an algorithm’s performance today is still to (i) train a bigger network and (ii) get more data
2. 构建dev set和test set
构建有效的dev set(验证集)和test set(测试集)的目的是为了:用于判别各种模型的优劣,以便于给出明确的优化方向
2.1 数据集有如下分类:
- train set: 用于训练模型的数据集
- dev set: 用于验证模型的数据,可用于验证模型调参,特征选择,结构设计等好坏,反馈给学习算法。验证集通常也可以从train set中hold out出来(如交叉验证)
- test set: 用于测试验证集验证后的模型,不可以参与模型训练的任何反馈。
2.2 如何选择test/dev set
最重要的原则:test/dev set 能够真实反映或评估模型最终应用的场景
具体细则:
-
test set和dev set要是同分布(如场景,事物类别,事物类别内的变化,pattern等):不一致的话会导致算法优化的可用的不确定性。
-
多大合适:dev set应该足够大能够反映不同算法的差异性。特别是某些应用领域如推荐算法,如果提高0.1%就有可能产生巨大的价值,这种情况下,dev set就要能反映0.1%的差异,如果你是1000或者10000可能都不能体现差异(从量上是1和10个数据区别太小了,不能有统计学上的代表性),可能10w或者更多是合适。 通常的数据量是1000到10000
-
test/dev set的评价指标:建立单一的标准(evaluation metric),多个标准则很难度量模型之间的好坏。无法统一成一个度量指标的时候,如既要考虑运行时间,又要考虑模型性能的多个指标情况下,通常的做法是给N-1个指标设定一个预期的最低标准阈值(可接受的),在这基础上尽可能的优化剩下的一个指标性能; 如运行时间在100ms都是可行的,在这些模型中不断的优化模型性能指标
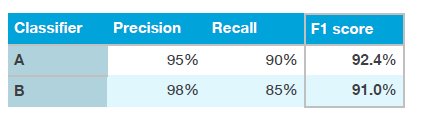
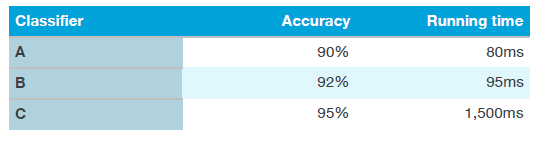
tips: Having a dev set and metric speeds up iterations
2.3 什么时候要调整test/dev set?
当你发现验证集的选择的模型不能正确反映真实应用场景的需求时, 比如验证集挑选了一个最佳的模型,但是你觉得其他模型可能更适合应用场景,此时就需要重新评估test/dev set
有可能出现问题的情况:
- 检查下test/dev set数据的分布情况
- 模型过拟合dev set: dev set是用来不断调整模型反馈的,有可能存在过拟合(这个时候就是test set存在的意义了),可能需要增加dev set
- 度量指标是否真实反映应用场景,比如挑选的最佳模型对于某些图片误识(这些图片可能是色情图片,绝对不允许的情况),可能要把这部分的因素考虑到评估指标里
tips: 开始项目前,尽可能在1周内确认好dev/test set
3. Error analysis(bad case or 错误分析)
-
不要一开始就要构建超级完美的系统,
-
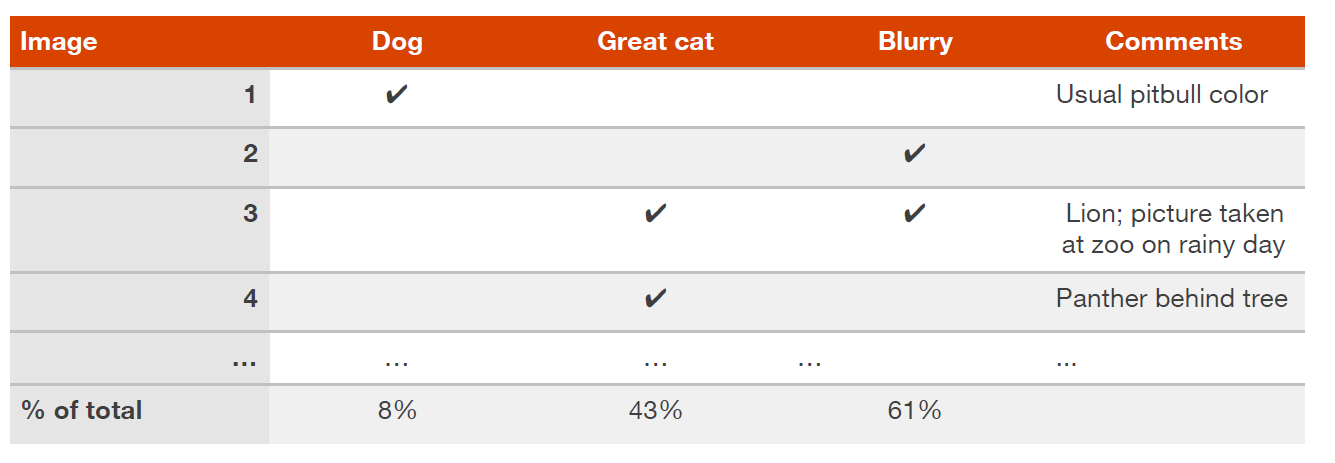
error analysis:检查误分类的样本。分析错误分类中最可能提高模型性能的方案。是否实施某一个方案有可能提升模型能力的百分比来决定。It provides a quantitative basis on which to decide whether to make this investment.
-
尝试给错误分一分类
-
清洗dev/test set中误标签的样本(可评估是否能容忍误标签)
-
如果dev set太多了, error样本也太多了,建议事先拆出一个eyeball-dev和black-box-dev, 人为进行eye dev set的分析
4. 偏差和方差
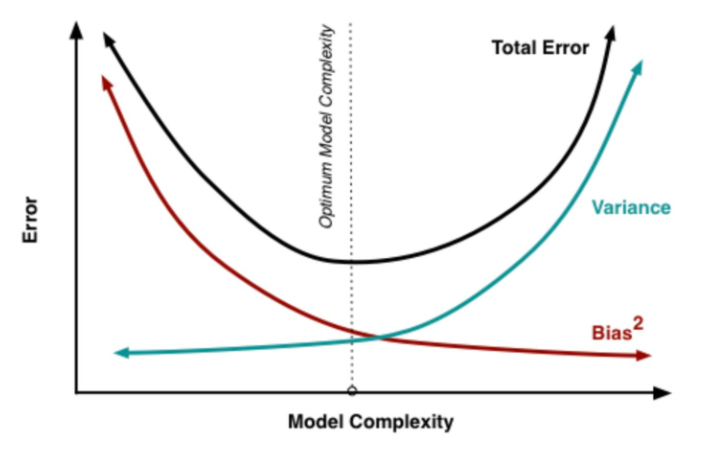
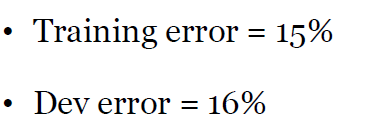
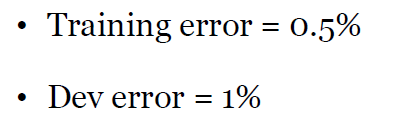
- 偏差bias:训练集的训练误差error rate
- 方差variance: dev/test set误差与训练误差的差异, 模型的泛化能力
-
高方差
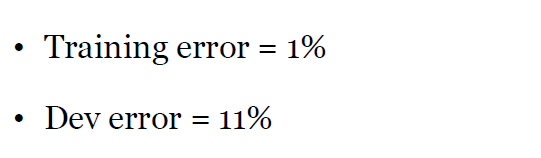
-
高偏差
-
低方差/低偏差
-
- 和最好的错误率对比:
optimal error rate 即最好的情况的极限的错误率,通常是指人类的水平,如果最好的情况只能达到14%, 那么偏差和方差最好和optimal error rate进行对照。
- reduce bias
(1) 增加模型容量 add model size(加大layer) (2)降低正则L2 L1或者droout (3)修改模型结构 - reduce variabce
(1)最有效的是根据error analysis 增加数据
(2)修改模型结构
5. 学习曲线(learning curve)
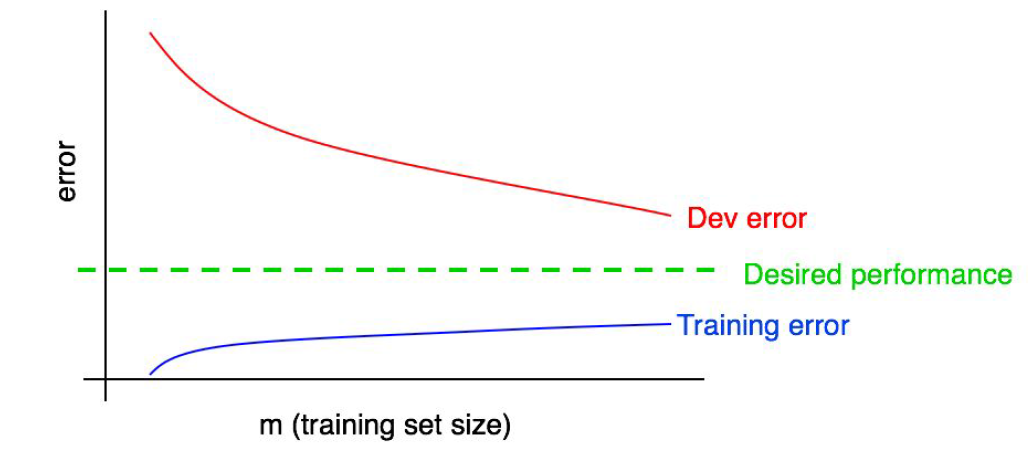
通过画学习曲线来评估算法在方差和偏差的程度。如上图,通常在不同train size情况,分别评估dev error和train error。
一般情况下,随着训练集的增加,train error会增加(模型需要学习更多特征,特别是误标签的情况,也不一定),而dev error下降(见过更多的pattern)。即bias增加,variance下降,上面说过加正则或者修改模型可以避免。
(1)如果dev error 出现平缓情况下, 增加数据的效果就显现不出来了, 模型学习不到更多的pattern或者增加的数据无用的。需要评估数据或者修改模型
(2)通常会添加一条期望error(中间的绿线),来评估迭代的效果(特别是在长期迭代的情况下)
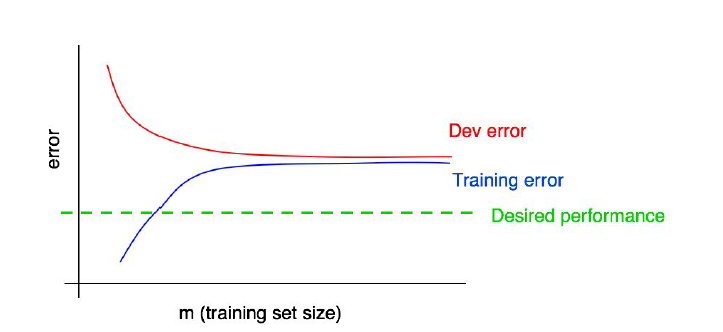
通过学习曲线来判断bias和variance
-
high bias: 此时看增加数据是无效的,试着改结构或者更大的模型
-
high variance
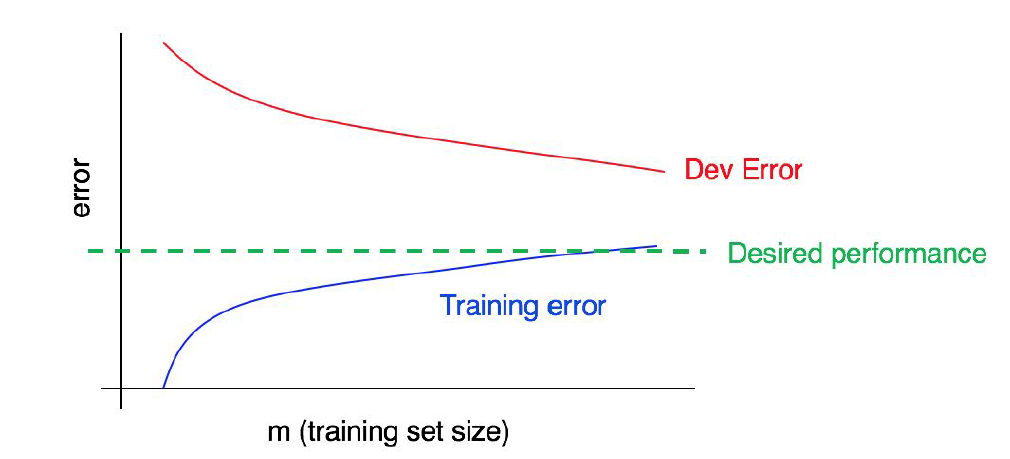
-
high variance and bias
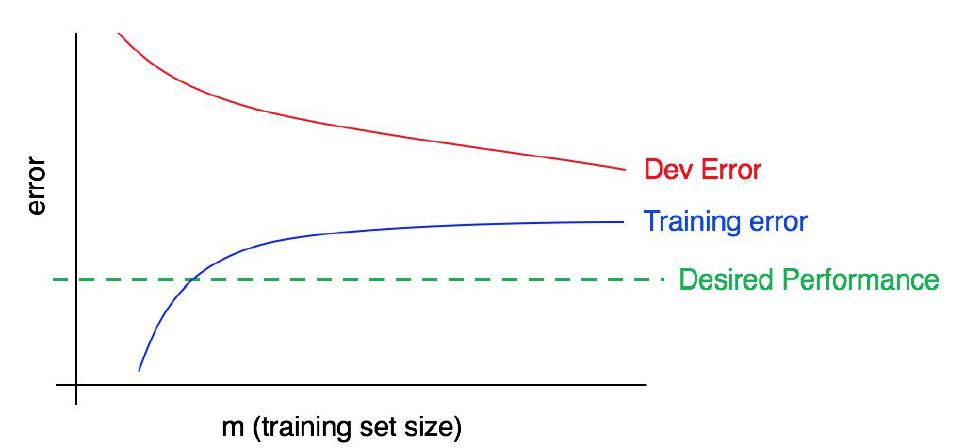
如何划分train set 来画learning curve? 为了避免随机抽取的train set造成无效的learning curve,可以有两种解决办法:
- 数量少的情况下, 可以多次抽取,来训练多个模型,然后做error均值
- 要保证类别的均衡
可以根据训练数据量的大小,以一定的数量如2000累加,创建不同的train set来训练模型,然后画出learning curve,评估下一步计划。
6. 和人类水平进行比较(human-level performance)
在人类能力范围内
- 可以通过人类行为进行打标
- 利用人类行为进行错误分析
- 用人类水平评估方差和偏差
- 超过人类水平之后:找出哪些人类比机器有效的进行优化
7. 当数据中不同分布的数据时
当训练模型时,采集的训练数据并一定和你最终模型的应用场景是完全一致的,之所以我们还需要这部分不同分布的数据是因为这些数据确实可以提供一些信息。比如你有网络上采集20000图片和手机用户拍摄的1000张图片,来训练一个手机应用。如何拆分数据集(train,dev,test set)
-
5k手机拍摄图片作为dev/test set, 剩下2.5w作为训练集,好处是dev/test的作用是验证模型是否在真实应用场景里有效
-
对数据样本加权重:
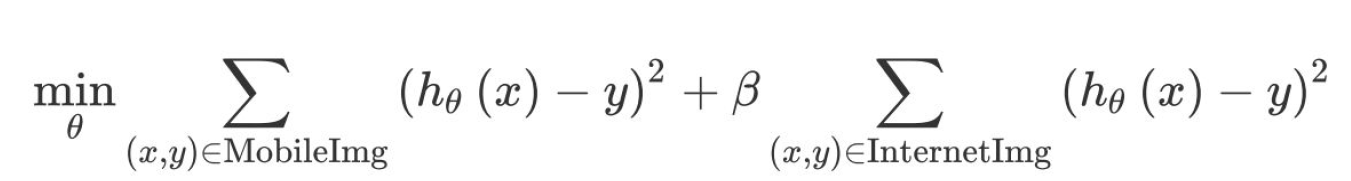
加入分布不一致数据的影响:
- 更多的数据,可以让neural network学习到更多的pattern; 不同分布的数据存在一定的共性,可能加强你希望分布的特征
- 更多的数据,使得模型需要拟合更多的pattern;如其他不同的分布有太多差异的特征,模型会有大量的容量来存储这些特征,可能会降低对于你希望分布的特征的提取。(对于传统算法,参数有限,remember this, forget other, 对于大容量的neutral network是没有的问题,但是不要加入无关的数据)
data mismatch问题
如果不同分布的数据在测试的发现在dev/test set上表现不如人意时,可能的原因:
- 高偏差bias: 在train set 拟合不好
- 高方差 variance: 在同分布的数据上泛化不好
- data mismatch: 在同分布的数据上泛化好, 但是在不同分布上泛化不好
为了验证如上的问题,需要拆解数据:
- train set: 包含不同分布的数据
- train dev set: 和train set同分布的数据集
- dev set: 反映最终应用场景的数据
- test set: 反映最终应用场景的数据
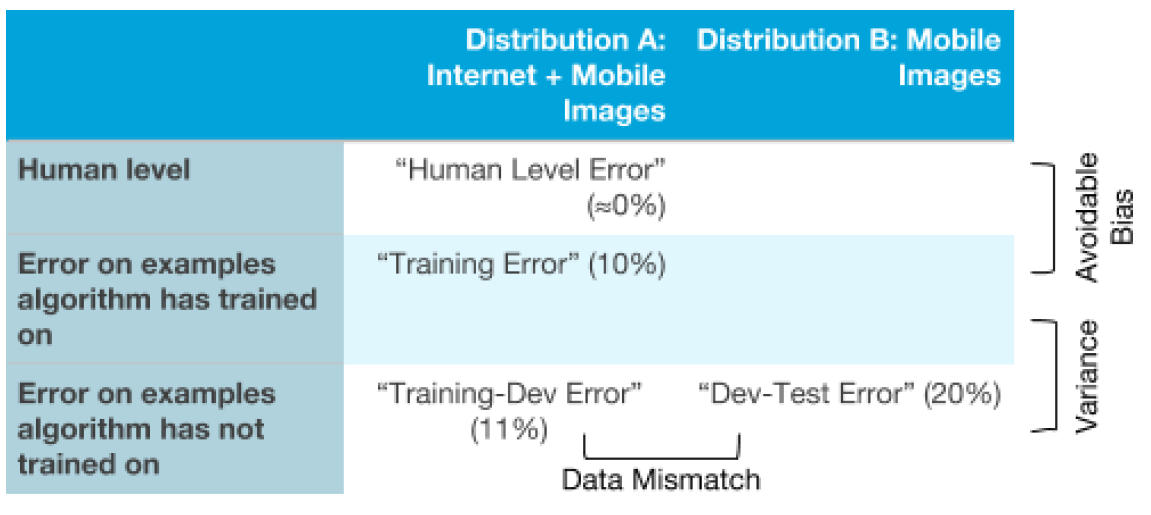
how to address the data mismatch
- 确认训练数据和dev set之间的那些数据特性的差异
- 尽可能寻找data match的数据
- 人造合成数据:小心过拟合人造数据overfit
比如语音识别,如果训练的数据都是在安静的环境下,而dev set 是嘈杂环境下的数据。这个就是差异。 如果模型在嘈杂环境下也表现良好,那还需要其他的差异。 这个就是error analysis的价值:找到显著的差异。
8. 是否使用end-to-end learning algorithm
-
piplines vs. end-to-end
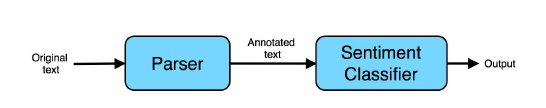
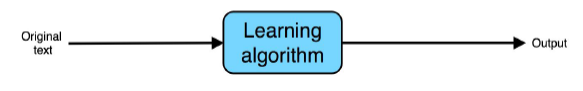
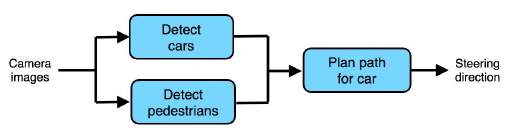
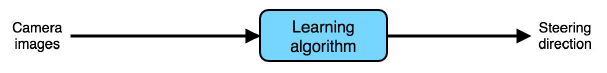
piplines通常需要更多人为的特征工程,相比end-to-end, piplines能提供有效的特征和先验的知识,而end-to-end需要重头从数据里去学习,如果没有大量的数据,可能效果会不尽如人意。 但是如果数据量大的情况,end-to-end算法能比piplines算法发现更多的其他特征,就会有很好的性能,end-to-end算法需要大量标签的数据。 如果数据量很少,算法的性能往往取决于人为的特征和先验知识。 -
可用数据
拿自动驾驶为例,piplines中的各个组成部分有足够的数据来训练模型,比如检测车辆,检测道路;而end-to-end方案中,需要图片和行驶方向的配对数据,这个很难获取可用的数据。piplines把问题拆分成多个不同的组成部分,最终的输出是组成部分依次执行的结果或者同时综合多个组合成分的结果。
-
任务的难易
可以把一个复杂的困难的任务拆解成多个组成部分,每个部分单独求解,组成一个piplines
-
piplines上每个组成部分的error analysis
由于pipline有多个组件组成,而且是相互顺序执行的,分析各个组件的错误,可以快速定位需要优化那个部分。
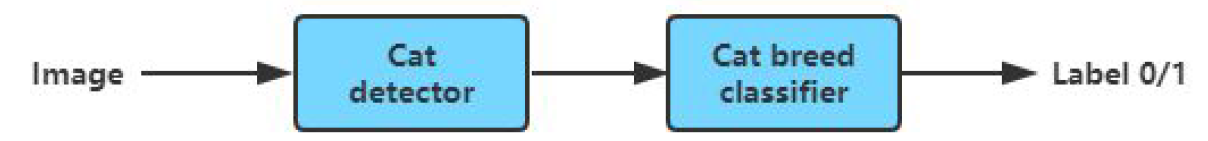
-
优化cat detector: 看dev set errors 数量比例
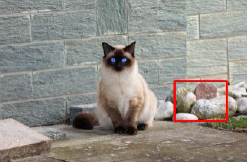
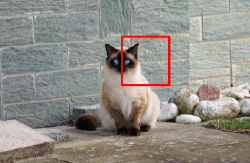
-
模棱两可的情况:人类在看到红框里也可以做出正确分类。
- case1: 给出认为正确的bbox,如果分类器可以正确分类,优化detetctor
- case2: 给出认为正确的bbox,如果分类器可以错误分类,优化classifier
在A-->B中以正确的A的输出输入A来判断错误归属谁,同理B-->C。 同时参照human-level performance
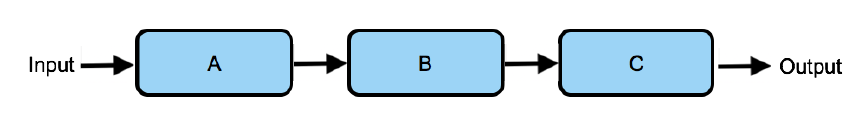
如果每个组件都表现良好,超过或接近人类水平,但是总体输出确不尽如人意,考虑piplines的问题,重新设计piplines
-