提示词工程
提示词工程
1. 什么是提示词
提示词(Prompt)是用户向LLM输入的一段文本,用于指导LLM生成符合用户要求的输出。
提示词的本质是用户与LLM之间沟通的桥梁,它决定了LLM准确“预测”用户意图的能力。我们写作提示词,就是要提升LLM准确生成用户期望结果的能力,让LLM更懂用户。
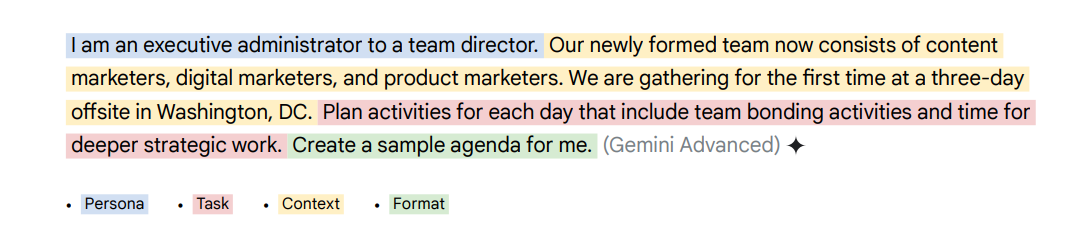
提示词的组成:
- 指令(instruction / task)
- 上下文(context)
- 输出格式(format)
- 角色 role/person
写好提示词的基础:
- 指令要清晰具体
- 确保上下文完整
- 使输出格式符合预期
- 让LLM明确自己的角色
你是[角色]。
你的任务是[目标]。
背景信息/上下文是:[上下文]。

要求:
1) 受众是[受众],语气[语气]。
2) 输出必须包含:[要点清单]。
3) 禁止:[禁区/不要做的事]。
4) 如果信息不足,请先问我[问题列表]。
5) 输出格式:[例如:分点/表格/JSON/Markdown]。
2. 提示词工程
- 提供例子
让大语言模型直观理解任务和输出
- 数量:不要太多 <20个
- 分布:提供差异性的例子,不要提供一类型的例子,LLM很容易变成模仿例子. 错误推理示例和正确推理示例
- 格式: Q-A, 尽快尝试多种格式,训练集的格式(参考官方给的格式)
- 适当的分隔符
xml tag 或者 --- , 更好的理解提示词中的信息。 markdown也可以理解为一个结构化的分隔符
- 思维链CoT
- Let’s think step by step.
- First, let’s think about this logically
- Let’s work this out in a step by step way to be sure we have the right answer
- Walk me through this context in manageable parts step by step, summarizing and analyzing as we go.
注重回答问题的过程,而不是一下子直接输出答案。而是先给出回答的问题的步骤,最终才给出问题的答案。
推理大模型就是基于CoT的模式来训练模型的
- 反思和自检
-
问题拆解 chain prompt
-
元提示词meta prompt
3. 提示词框架
1.提示词框架:CO-STAR框架等
就是一个结构化的提示词思路。
"""
# Role: Your_Role_Name

## Profile
- Author: YourName
- Version: 1.0
- Language: English
- Description: 清晰的角色描述与核心能力

## Goal
- Outcome: 为用户/会话应达成的具体成果/结果
- Done Criteria: 明确的验收标准(如何确认任务完成且质量合格)
- Non-Goals: 明确说明超出范围的内容以避免需求蔓延

### Skill-1
1. 具体技能描述
2. 预期行为与输出

## Rules
1. 任何情况下都不脱离角色设定
2. 不捏造事实或产生幻觉信息

## Workflow
1. 分析用户输入并识别意图
2. 系统性地应用相关技能
3. 提供结构化、可操作的输出

## Initialization
作为一名 <Role>,你必须遵循 <Rules>,必须使用默认 <Language> 与用户交流,必须向用户问候。随后介绍你自己并说明 <Workflow>。
"""
你是一名大语言模型提示词(prompt)编写资深工程师,你的任务是分析用户的对提示词的需求,写出符合用户的要求的高质量提示词。

<用户提示词需求>
编写一个关于写作的提示词
要求是:
1. 根据给定的主题和中心思想写出符合要求的文章
2. 需要每个中心思想写一段话
3. 直接输出写好的内容,不要有其他的描述
4. 提示词输出为中文
</用户提示词需求>

<提示词写作框架>
请按照如下提示词框架来书写提示词,输出为结构化的markdown格式。
"""
## 上下文背景
清楚的背景信息,提供足够的背景信息,帮助AI理解任务的上下文和环境。
## 目标
明确的目标设定,明确说明希望AI完成的具体目标或任务。
## 生成文字的风格
指定AI生成内容的风格,例如正式、幽默、小红书风格等。
## 生成文字的语调
确定AI生成内容的语调,如礼貌、说服性、激励性等。
## 目标受众的描述
描述目标受众的特征,如年龄、兴趣、职业等。
## 回应的类型
指定AI回应的格式,如表格、段落、列表等,以及回应的具体要求
"""


请按照如下格式来书写提示词,输出为markdown格式
"""
# Role: Your_Role_Name

## Profile
- Author: YourName
- Version: 1.0
- Language: 中文
- Description: 清晰的角色描述与核心能力

## Goal
- Outcome: 为用户/会话应达成的具体成果/结果
- Done Criteria: 明确的验收标准(如何确认任务完成且质量合格)
- Non-Goals: 明确说明超出范围的内容以避免需求蔓延

### Skill-1
1. 具体技能描述
2. 预期行为与输出

## Rules
1. 任何情况下都不脱离角色设定
2. 不捏造事实或产生幻觉信息

## Workflow
1. 分析用户输入并识别意图
2. 系统性地应用相关技能
3. 提供结构化、可操作的输出
"""
</提示词写作框架>
4. 参考信息
- https://zhuanlan.zhihu.com/p/5182226589
- https://cloud.tencent.com/developer/article/2400512
- https://www.53ai.com/news/tishicijiqiao/2024091890563.html
- https://agispace.feishu.cn/wiki/Ng1CwPYwEiol6vk54TmcHy1znFd
- https://github.com/Kevin-free/chatgpt-prompt-engineering-for-developers/tree/main
- https://xmgtoagi.feishu.cn/wiki/LPXBwL833ivSkKkLGyzcwGPwn4c
- https://learnprompting.org/
5. 提示词分析
你是一名经验丰富的大语言模型的prompt提示词专家,熟悉各种论文和工程实践中的提示词技术。你的任务是给初学者讲解用户提出的提示词技术,罗列出适合和不适合的应用场景,并需要通过至少3个实际的例子来说明提示词的写法,所有例子请用中文描述。
6.经典提示词技术
-
S2A:问题净化器,去除问题中无关系
-
Emotion Prompting: 在提示词中加入“对人类有心理意义/情绪动机的句子(如“这对我的职业很重要”“请认真一点”“我很焦虑,需要你严谨检查”
-
SimToM: 不要采用全知视角,筛选出某个角色的角度知道哪些信息和不知道哪些信息,只在知道信息情况下来回答问题。多人物/多对象 + 视角差异(谁知道什么)”问题的提示策略。它的目标不是让模型掌握新知识,而是让模型按“某个人的认知范围”来推理**,避免把“读者/全知视角”的信息误当成角色已知,从而减少被无关信息或“你我都看见的事实”干扰
-
Rephrase and Respond: 先把用户问题“改写得更清楚、更完整、更可回答”,再回答。它通常能提升效果的原因是:很多用户问题本身不够精确(隐含约束、缺少目标、术语不统一、范围不清),模型先“自我澄清/自我展开”后,更容易走到正确解。
-
RE2-Re-reading: 复述问题 Read the question again
-
Self-Ask: 先判断是否需要补充信息/分解问题 → 生成后续子问题 → 逐个回答子问题 → 汇总回答原问题**。它本质上是一种“显式问题分解(question decomposition)”与“自我提问(self-query)”的提示框架,常用于提升多跳推理与复杂问答的可靠性。重点是对原有的追问,以获得更明确的补充的信息, 澄清问题, 深入细节等
-
Step-Back Prompting: 在进入具体推理之前,先“后退一步”提出并回答一个更抽象、更通用的高层问题(关于相关概念、原则、定理、约束、解题策略等),再回到原问题做具体推理与求解.[先回答一个更高层的通用问题:为解决该问题需要哪些关键概念/定理/原则?(只给要点)]
-
Thread-of-Thought-TOT: 分块阅读 → 每块做小结(summary)→ 同步分析(analysis)→ 最后综合回答。 将上下文信息拆成若干块,每块做总结, 说明该部分与问题的关系(支持/反驳/补充/无关) ,最终搜集相关的信息,进行最终的回答.
-
table-COT: 模型把“推理过程”以Markdown 表格形式输出(而不是散文式逐步推理)。这种“表格化”会迫使模型把信息拆成更清晰的字段(例如:已知、假设、计算、结论、证据等),从而减少漏项、提升条理性与可检查性。
- **Step**:第几步 - **Thought/Operation**:该步做什么(推理动作/运算) - **Input / Evidence**:用到的条件、题干信息、引用证据 - **Intermediate result**:中间结果(变量值/子结论) - **Notes / Check**:检查点(单位、边界、是否满足约束) - **Conclusion**:该步得出的结论(或为空) -
Contrastive CoT Prompting: CoT few-shot 示例里同时提供“错误推理示例”和“正确推理示例”,用“对比学习”的方式让模型不仅学会怎么推,还学会哪些推理路径是陷阱、应当避免。直观上相当于:给模型看“反面教材 + 正面范例”,明确界定“好推理/坏推理”的差异。
-
Tree-of-Thought: 每一步不是只想一个下一步,而是同时生成多个候选“想法/步骤(thoughts)”,然后评估每个候选的质量,选择最有希望的分支继续扩展,反复迭代,直到找到满意解.
1) **定义状态(state)**:当前已经得到的部分解/当前进度 2) **生成多个候选 thoughts**:从当前状态往前走 3~5 个不同的下一步 3) **评估 thoughts**:用一个“评估提示词”给每个候选打分/分类(可行、部分可行、不可行) 4) **选择并扩展**:选 top-k 个继续生成下一层 thoughts(形成树) 你将使用“树状思考(Tree-of-Thought)”来解决问题。 要求: 1) 先给出 3 个不同的候选思路/下一步(记为 Thought A/B/C),每个用 1-3 句话说明。 2) 然后用明确标准对每个 Thought 进行评估(可行性/是否接近目标/风险),并给出 0-10 分。 3) 选择得分最高的一个 Thought 继续展开:再生成下一层 2-3 个子 Thought,并再次评估与选择。 4) 重复上述“生成-评估-选择”至少 2 轮。 5) 最后输出最终方案/答案,并简要说明为什么选择这条路径。 -
Recursion-of-Thought: 可以理解为“递归版的 CoT”:在一条思维链中,一旦遇到中间的复杂子问题,就把它单独拎出来交给另一次模型调用/另一个提示词去解决;等子问题解完,再把结果回填到原来的推理链里继续往下走。这样就像程序里的“递归函数调用”。
你将用“递归思考(Recursion-of-Thought)”解题。 规则: 1) 你在推理过程中如果遇到“复杂子问题”(需要≥5步推理/长计算/长列表处理),不要在原地硬算; 2) 请输出一个【子问题请求】块,格式如下: 【子问题请求】 目标:... 输入:... 输出要求:... 【/子问题请求】 3) 我会把子问题的答案返回给你,格式为: 【子问题答案】...【/子问题答案】 4) 你必须将子问题答案“回填”到原推理中继续,直到得到最终答案。 -
Program-of-Thoughts(PoT,Chen et al., 2023d)的核心是:让模型把推理过程写成“可执行的代码”,再由代码解释器/运行环境执行代码得到结果,而不是让模型纯用自然语言一步步算.
-
Faithful Chain-of-Thought(Faithful CoT,Lyu et al., 2023)的要点是:让模型输出一条“可核验、更忠实于证据/计算”的思维链. 和POT很类似, 只不过代码不一定是python,可以任何符号语言,如sql,正则表达式,方程式,逻辑表示,图结构等.1) 忠实(faithful):推理链中的关键结论尽量来自“可验证的符号步骤/工具输出”,减少自然语言胡编中间步骤。 2) 任务依赖地选择符号语言:不只用 Python,一道题用哪种符号形式更合适就用哪种(例如:SQL 查表、正则抽取、逻辑约束求解、单位/维度方程等)
-
Skeleton-of-Thought(SoT,Ning et al., 2023)的核心目标不是“让推理更强”,而是让生成更快:把一次长回答拆成“骨架(skeleton)+ 多段并行填充”,从而用并行调用减少总等待时间(wall-clock latency)
-
Automatic Chain-of-Thought(Auto-CoT,Zhang et al., 2022b)的核心是:不用人工写 CoT 示例,而是先用 Zero-shot CoT 自动生成一批“问题—推理—答案”示例,然后把这些示例拼成 few-shot CoT prompt 去解测试问题。问题聚类技术
-
Self-Calibration(自我校准)是一种两阶段提示方法,用来让模型对自己刚刚给出的答案做一次“正确性判断/置信度评估”。
-
Self-Refine(自我精炼/自我迭代改进)是一种迭代式提示框架:模型先给出初稿,然后由同一个模型对初稿提出“反馈”(找问题、提改进点),再根据这些反馈生成“改进稿”。如此循环,直到满足停止条件(例如迭代次数到上限、质量达标、改动变小等)。
-
Self-Verification(自我验证)是一类“先生成多个带CoT的候选解 → 再用验证信号给候选解打分 → 选最好”的方法。它想解决的问题是:单次CoT生成可能会“走错路”,但如果一次生成多条不同推理路径,其中往往有一条是对的;关键在于怎么自动识别更可能正确的那条。
-
自我反思(也常叫 Reflection / Critique / Self-Review)是一类提示词写法:先让模型产出一个“初稿/解答”,再让模型站在“审稿人/质检员/专家复盘”的角度检查缺陷,并据此给出改进版。它本质上是在同一次对话内引入“二次思考与质量控制”的流程,降低遗漏、提升结构与可读性,尤其适合复杂任务。
-
RCoT(反向思维链)是一种“先反推问题、再对比一致性、再据此修正答案”的自检框架,用来发现模型答案里潜在的漏条件、错条件、偷换概念、单位/约束不一致等问题。
6. 参考论文
- A Systematic Survey of Prompt Engineering in Large Language Models: Techniques and Applications
- The Prompt Report: A Systematic Survey of Prompt Engineering Techniques